
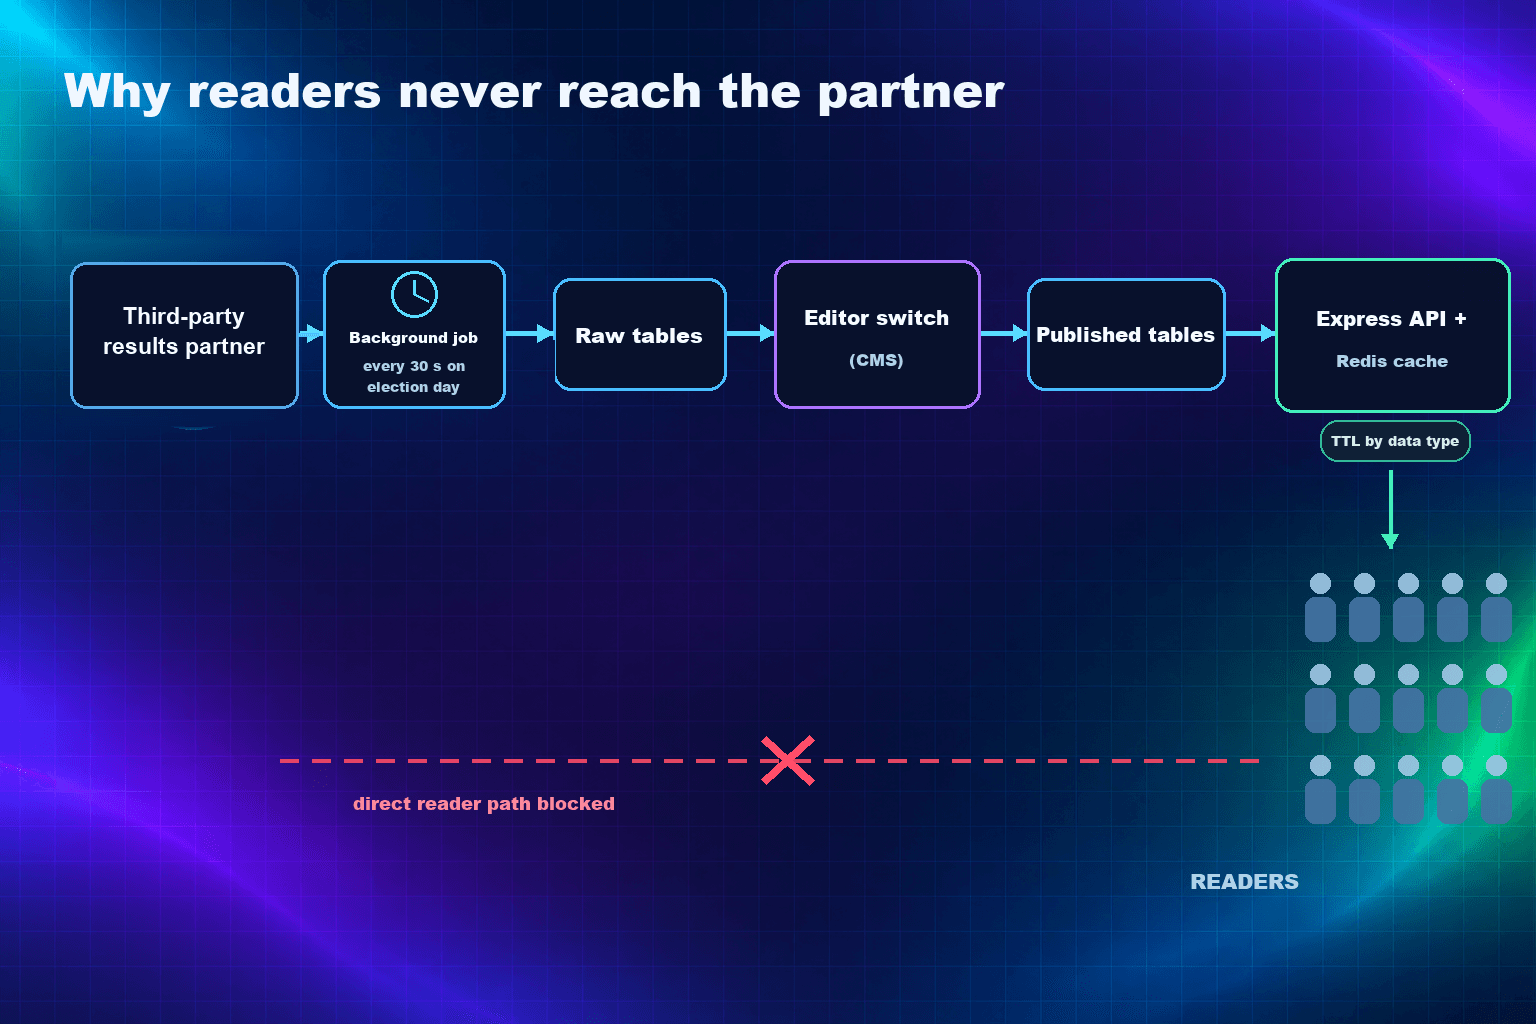
API ผลเลือกตั้งผู้ว่าฯ กทม. 2569 ของไทยรัฐรับมือ traffic สูงด้วยสามอย่าง: Redis cache หน้า Express ที่สร้าง key จาก URL และตั้งอายุตามประเภทข้อมูล, background job ที่ดึงข้อมูลจากผู้ให้บริการผลคะแนนภายนอกแทนผู้อ่าน พร้อมสลับ API key เมื่อเจอ 429 และตารางสองชั้นที่ข้อมูลจะขึ้นเว็บก็ต่อเมื่อบรรณาธิการเปิดสวิตช์ใน CMS ผู้อ่านจึงไม่เคยยิงตรงไปที่ผู้ให้บริการ และตัวเลขที่ยังไม่ผ่านการตรวจไม่หลุดขึ้นหน้าเว็บ (ข้อมูล ณ ตุลาคม 2026)
ช่วงหาเสียงเลือกตั้งผู้ว่าฯ กทม. 2569 (5 พฤษภาคม – 28 มิถุนายน 2026)
เว็บเลือกตั้งของไทยรัฐมีการเปิดดูราว
2.37 ล้านครั้งจากผู้ใช้ราว 91,000 คน (ตัวเลขจาก analytics แบบคร่าวๆ ของจริงน่าจะสูงกว่านี้) ผมเป็นคนเขียน API หลังบ้านที่ส่งข้อมูลให้หน้าเว็บ บทความนี้เล่าว่า API ตัวนี้ออกแบบอย่างไรให้ผู้อ่านจำนวนมากไม่กลายเป็น request ที่ไปถล่มผู้ให้บริการผลคะแนน และให้ตัวเลขผิดไม่หลุดขึ้นหน้าเว็บ
ระบบนี้มีหน้าที่อะไร และยากตรงไหน?
API ตัวนี้ต้องทำสามอย่างพร้อมกัน:
- ส่งข้อมูลให้ผู้อ่านจำนวนมากโดยไม่ช้า
ทั้งข้อมูลที่แทบไม่เปลี่ยน (50 เขต, ผู้สมัครผู้ว่าฯ 18 คน และ ส.ก. 258 คน, 10 พรรค) และข้อมูลที่เปลี่ยนทุกนาทีในคืนนับคะแนน
- ไม่ยิงผู้ให้บริการผลคะแนนเกินเพดาน
ผลคะแนนมาจากผู้ให้บริการภายนอกที่มี rate limit ถ้าส่ง request ของผู้อ่านทุกคนไปตรงๆ จะโดน 429 ภายในไม่กี่นาที
- ให้บรรณาธิการคุมได้ว่าตัวเลขไหนขึ้นเว็บ
สำนักข่าวเผยแพร่ตัวเลขที่ยังไม่ได้ตรวจไม่ได้
Stack ที่ใช้คือ Express 5, PostgreSQL ผ่าน Drizzle ORM, Redis (ioredis) และ Agenda สำหรับ background job รันใน Docker บน Kubernetes และ deploy ผ่าน Jenkins
ทำ Redis cache หน้า Express ให้ใช้ได้จริงต้องคิดเรื่องอะไรบ้าง?
ผมทำ cache เป็น middleware ตัวเดียว ใส่หน้า route ไหนก็ได้ จุดที่ต้องคิดมีห้าข้อ:
- 1.Key ต้องไม่แตกโดยไม่จำเป็น
key คือ method + path + query string ที่
เรียงลำดับแล้วและตัดพารามิเตอร์ cache ออกทำให้ ?a=1&b=2 กับ ?b=2&a=1 ใช้ cache ก้อนเดียวกัน
function buildCacheTarget(req) { const [path, search = ''] = req.originalUrl.split('?') const params = new URLSearchParams(search) params.delete('cache') params.sort() const q = params.toString() return q ? `${path}?${q}` : path } - 2.มีทางสั่ง cache จาก URL
เติม ?cache=refresh เพื่อข้าม cache แล้วเขียนค่าใหม่ทับ หรือ ?cache=bypass เพื่อข้ามโดยไม่เขียน ทุก response มี header X-Cache บอกว่าเป็น HIT, MISS, REFRESH หรือ BYPASS ไล่ปัญหาได้จาก DevTools ทันที
- 3.Cache เฉพาะ response 2xx
error ไม่ถูกเก็บ ถ้าฐานข้อมูลสะดุดชั่วคราว ผู้อ่านจะไม่เจอ error เดิมซ้ำจนหมดอายุ cache
res.json = (body) => { res.json = originalJson if (mode !== 'bypass' && res.statusCode >= 200 && res.statusCode < 300) { setCache(key, { body, statusCode: res.statusCode }, ttl) .catch((err) => logger.warn({ err, key }, 'cache write failed')) } return originalJson(body) } - 4.Cache พังต้องไม่ทำให้ API พัง
ถ้าอ่านหรือเขียน Redis ไม่สำเร็จ ระบบแค่บันทึก log แล้วไปต่อ cache เป็นตัวช่วย ไม่ใช่จุดที่ทำให้ทั้งระบบล่ม และมีสวิตช์ปิด cache ทั้งระบบผ่าน environment variable
- 5.บีบอัดค่าที่ใหญ่
ค่าที่ใหญ่กว่าเกณฑ์จะถูก gzip ก่อนเก็บ และติด prefix ไว้ให้รู้ว่าค่าไหนต้องคลาย ข้อมูลรายเขตที่เป็น JSON ก้อนใหญ่จึงใช้หน่วยความจำ Redis น้อยลง
ข้อมูลแต่ละแบบควร cache นานเท่าไร?
ไม่มีค่าเดียวที่ถูกสำหรับทุก route ผมตั้งตามว่าข้อมูลเปลี่ยนบ่อยแค่ไหน:
ข้อมูล | TTL | เหตุผล |
|---|---|---|
Livestream | 60 วินาที | ต้องสลับลิงก์ได้เร็วในคืนเลือกตั้ง |
ผลคะแนนสด (สถิติ, คะแนนรายเขต, พรรค) | ค่า default (5 นาที ปรับได้ด้วย env) | job ดึงข้อมูลบ่อยกว่านี้ และล้าง cache ได้จาก CMS |
ฟีดข่าวและไทม์ไลน์ | 10 นาที | ขยับจากค่า default 5 นาทีเมื่อ 21 พฤษภาคม 2026 เพราะข่าวไม่จำเป็นต้องสดระดับนาที |
ข้อมูลหลัก (เขต, ผู้สมัคร, พรรค) และผลปี 2565 | 1 วัน | แทบไม่เปลี่ยนเลย |
ส่วนที่ทำให้ TTL ยาวๆ ใช้ได้โดยไม่กลัวข้อมูลค้าง คือปุ่ม
Clear Cacheใน CMS ที่ลบ key ตาม pattern ของ path (ใช้ SCAN ทีละชุดแทน KEYS เพื่อไม่ให้ Redis ค้าง) บรรณาธิการแก้ข้อมูลแล้วกดล้างได้เองโดยไม่ต้องรอ developer
รับมือ rate limit 429 ของผู้ให้บริการภายนอกอย่างไร?
ข้อแรกคือ
ผู้อ่านไม่เคยยิงไปที่ผู้ให้บริการเองทุก request ของผู้อ่านอ่านจากฐานข้อมูลของเราผ่าน cache ส่วนการดึงจากผู้ให้บริการเป็นหน้าที่ของ background job ตัวเดียว จำนวน request ไปหาผู้ให้บริการจึงขึ้นกับรอบของ job ไม่ใช่จำนวนผู้อ่าน
ข้อสองคือ client ที่คุยกับผู้ให้บริการมี API key สองตัว และ interceptor ของ axios ที่จัดการ 429 เป็นรอบสามขั้น:
- 1.
429 จาก key แรก → สลับไป key สองทันที
- 2.
429 จาก key สอง → รอตามเวลาที่ผู้ให้บริการบอก (header retry-after หรือเวลา reset ใน body) แล้วกลับไปใช้ key แรก
- 3.
429 จาก key แรกอีกครั้ง → สลับไป key สอง ครบหนึ่งรอบ
ครบรอบแล้วยังไม่ผ่าน นับเป็น retry หนึ่งครั้ง และเริ่มรอบใหม่ได้อีกสองครั้งก่อนยอมแพ้ ส่วน error อื่นที่ไม่ใช่ 429 จะ retry แยกสองครั้ง เว้น 5 วินาที
client.interceptors.response.use(null, async (error) => {
  const { config, response } = error
  if (response?.status !== 429) return retryOtherErrors(error)


  config.attempt429 = (config.attempt429 || 0) + 1
  const usingFirstKey = config.headers.Authorization === KEYS[0]


  if (usingFirstKey && config.attempt429 === 1) return withKey(config, KEYS[1])
  if (!usingFirstKey && config.attempt429 === 2) {
    await sleep(waitFrom(response)) // retry-after header, or reset time in body
    return withKey(config, KEYS[0])
  }
  // ...step 3, then restart the cycle up to 2 times
})
สิ่งที่ผมได้เรียนรู้: การเคารพ retry-after สำคัญกว่าการ retry เร็ว ถ้า retry ทันทีโดยไม่รอ เราแค่เผาโควตาของ key ที่สองไปเปล่าๆ
ทำไมต้องแยกข้อมูลดิบกับข้อมูลที่เผยแพร่?
ข้อมูลจากผู้ให้บริการถูกเก็บในตาราง
rawก่อนเสมอ แล้วค่อยคัดลอกไปตาราง
ที่เผยแพร่ซึ่งเป็นตารางที่ API อ่าน ขั้นที่สองนี้ทำงานก็ต่อเมื่อสวิตช์ "อัปเดตจากผู้ให้บริการ" ใน CMS เปิดอยู่
export async function publishStatistics(electionType, source) {
  const { allowPartnerUpdate } = await getCmsConfig()
  if (!allowPartnerUpdate) return // editors hold the published tables


  const raw = await db.query.rawStatistics.findFirst({ /* by election + source */ })
  if (!raw) return
  await db.insert(publishedStatistics).values(raw)
    .onConflictDoUpdate({ target: [/* election, source */], set: /* ... */ })
}
ผลคือ:
ถ้าข้อมูลจากผู้ให้บริการดูผิดปกติ บรรณาธิการปิดสวิตช์ได้ทันที หน้าเว็บค้างที่ตัวเลขล่าสุดที่ผ่านการตรวจ ส่วนข้อมูลดิบยังไหลเข้ามาให้ตรวจต่อได้
CMS ยังเลือก
แหล่งข้อมูลได้สามแบบ คือ auto, realtime (ผลนับเร็ว) หรือ final (ผลทางการ) และ override ราย request ได้ด้วยพารามิเตอร์ source
route ผลคะแนนสดแนบค่าตั้งของ CMS (แหล่งข้อมูล, เปิดรีเฟรชอัตโนมัติไหม, ทุกกี่วินาที) ไปกับ response หน้าเว็บจึงรู้เองว่าต้องรีเฟรชถี่แค่ไหน โดยไม่ต้อง deploy ใหม่ ในคืนเลือกตั้งการรีเฟรชสดทำงานได้ตามที่ตั้งไว้
Background job ปรับอย่างไรในวันเลือกตั้ง?
ใช้ Agenda เก็บ job ไว้ใน PostgreSQL ตัวเดียวกับข้อมูล มีสอง job:
- updateMaster
ข้อมูลหลัก (เขต, ผู้สมัคร) ทุก 1 วัน
- updateDynamic
สถิติ, คะแนนรายเขต, คะแนนผู้สมัคร และพรรค ทั้งแบบ realtime และ final
ทั้งสองตั้ง concurrency เป็น 1 กันไม่ให้รอบซ้อนกัน และข้างในใช้ p-limit(5) จำกัดให้คุยกับผู้ให้บริการพร้อมกันได้ไม่เกินห้า request
รอบของ updateDynamic คือ 5 นาทีตลอดช่วงหาเสียง แล้วในวันเลือกตั้ง 28 มิถุนายน 2026 ผมปรับเป็น 1 นาทีตอน 16:57 และ 30 วินาทีตอน 17:20 เมื่อเริ่มนับคะแนน ผู้อ่านไม่รู้สึกถึงการเปลี่ยนแปลงนี้เลย เพราะเขาอ่านจาก cache เสมอ
สิ่งที่ยังไม่ได้ทำ และจะทำต่อ
- ไม่มีผล load test
ใน repo มีสคริปต์ benchmark สำหรับ Redis แต่ไม่มีผลที่บันทึกไว้ ตัวเลข traffic ในบทความนี้มาจาก analytics ไม่ใช่การทดสอบ
- TTL ของผลคะแนนสดกับรอบของ job ยังแยกกันอยู่
ครั้งหน้าผมจะผูกสองอย่างนี้เข้าด้วยกัน หรือให้ job ล้าง cache ของ route ที่เกี่ยวข้องเองหลังเขียนข้อมูลใหม่
- ตัวเลข traffic เป็นค่าคร่าวๆ
ของจริงน่าจะสูงกว่านี้
FAQ
ทำไมไม่ให้หน้าเว็บเรียกผู้ให้บริการผลคะแนนตรงๆ?
เพราะจำนวน request จะเท่ากับจำนวนผู้อ่าน และผู้ให้บริการมี rate limit ให้ job ฝั่งเซิร์ฟเวอร์ดึงข้อมูลเป็นรอบแล้วเก็บไว้เอง จำนวน request ไปหาผู้ให้บริการจะคงที่ไม่ว่าผู้อ่านจะมากแค่ไหน และ API key ก็ไม่ต้องอยู่ฝั่ง browser
ใช้ ?cache=refresh แล้วคนทั่วไปล้าง cache ได้ไหม?
refresh แค่ข้าม cache ของ request นั้นแล้วเขียนค่าใหม่ ไม่ได้ลบ cache ทั้งหมด แต่ถ้ามีคนยิงรัวๆ ก็เท่ากับไม่มี cache สำหรับ URL นั้น ระบบที่ใหญ่ขึ้นควรจำกัดพารามิเตอร์นี้ให้เฉพาะคนในทีม ส่วนการล้าง cache ตาม pattern อยู่หลังการล็อกอินของ CMS
ทำไมไม่ cache response ที่เป็น error?
ถ้าเก็บ error ไว้ ปัญหาชั่วคราวไม่กี่วินาทีจะกลายเป็น error ที่ผู้อ่านเห็นนานเท่ากับ TTL ไม่เก็บ error แล้วปล่อยให้ request ถัดไปลองใหม่จะปลอดภัยกว่า
ทำไมใช้ Agenda แทน cron?
Agenda เก็บสถานะ job ในฐานข้อมูล จึงเห็นว่า job ไหนรันเมื่อไรและพังไหม ตั้ง concurrency กันรอบซ้อนได้ และเปลี่ยนรอบได้ด้วยการแก้โค้ดบรรทัดเดียว ซึ่งเป็นสิ่งที่ผมทำจริงในวันเลือกตั้ง
Redis ล่มแล้วเว็บล่มด้วยไหม?
ไม่ การอ่านหรือเขียน cache ที่ล้มเหลวจะถูกบันทึก log แล้ว request ไปต่อที่ฐานข้อมูลตามปกติ เว็บจะช้าลงแต่ไม่พัง
สรุป
✅ Cache key จาก URL ที่เรียงแล้ว, cache เฉพาะ 2xx และ cache พังต้องไม่ทำให้ API พัง
✅ ตั้ง TTL ตามความถี่ที่ข้อมูลเปลี่ยน แล้วให้คนหน้างานล้าง cache เองได้
✅ ผู้อ่านไม่คุยกับผู้ให้บริการภายนอกเลย มีแค่ job เดียวที่คุย และเคารพ retry-after
✅ แยกตาราง raw กับตารางที่เผยแพร่ ให้บรรณาธิการถือสวิตช์
👉 อ่านต่อ:
ทำ infinite masonry feed ใน Next.jsจากโปรเจกต์เดียวกัน,
ภาพรวมโปรเจกต์เว็บเลือกตั้งและ
checklist SEO สำหรับ Next.jsLast verified: 31 ตุลาคม 2026 จาก source code ของโปรเจกต์ (Express 5, ioredis 5, Agenda 6, Drizzle ORM 0.45)
แหล่งอ้างอิง: