
Clef กับ Clairic เป็นโมเดลของ Cloudflare บน Workers AI ที่
ไม่เขียนข้อความClef รับข้อมูลกับรายการตัวเลือกที่เรากำหนด แล้วตอบเป็นความน่าจะเป็นของแต่ละตัวเลือก ส่วน Clairic ดึงค่าที่มีชนิดชัดเจน (ตัวเลข วันที่ ข้อความบางช่วง ค่าประมาณ) ออกจากข้อความหรือรูป ทั้งคู่ตอบในรอบเดียวและคิดเงินแค่ input token ผมลองเรียกจริงราว 20 ครั้งบน free tier ใช้ไปประมาณ 86 Neurons จากโควตาฟรี 10,000 ต่อวัน กับภาษาไทย Clef-flash จัดหมวดข้อความถูก 4 จาก 5 แต่ Clairic อ่านปี พ.ศ. ผิดแบบมั่นใจสูง Clairic ยังเป็น preview และ benchmark ทั้งหมดเป็นของ Cloudflare เอง (ข้อมูล ณ 5 พฤศจิกายน 2026)
ในหลายระบบ เราเรียก LLM ตัวใหญ่ทุกครั้งที่ต้องตอบคำถามง่ายๆ อย่าง "ticket นี้ด่วนไหม" หรือ "ยอดรวมในใบนี้เท่าไหร่" แล้วต้องรอมันพิมพ์ JSON ออกมาทีละ token จ่ายค่า output token ทั้งที่คำตอบสั้นนิดเดียว จากนั้นก็ต้อง parse และตรวจซ้ำอีกรอบ เดือนตุลาคม 2026 Cloudflare ออกโมเดลสองตระกูลที่ตั้งใจมาแก้ตรงนี้
ผลในโพสต์นี้มาจาก
Worker ตัวอย่างเล็กๆ ที่ผมเคยสร้างไว้ deploy ขึ้น Workers free tier รันชุดทดสอบ แล้วลบ Worker ทิ้ง(5 พ.ย. 2026) โค้ดทั้งหมดอยู่ใน
gist นี้(index.ts, run-tests.ts และ make-receipt.py) ใครอยากลองให้ deploy สำเนาของตัวเองบนบัญชีของตัวเอง ขอบอกขนาดการทดสอบตรงๆ: เรียกสำเร็จราว 20 ครั้ง ใช้อีเมลภาษาอังกฤษหนึ่งฉบับ ข้อความลูกค้าภาษาไทยห้าข้อความ และรูปใบเสร็จที่วาดขึ้นเองหนึ่งรูป ข้อมูลทั้งหมดเป็นข้อมูลสมมติ ส่วนใหญ่รันครั้งเดียว ผลจึงเป็นแค่ตัวอย่างให้เห็นภาพ ไม่ใช่ benchmark ผมไม่ได้เทียบกับ Jev และไม่ได้วัดความเร็วแบบเป็นระบบ ตัวเลขความเร็วและ benchmark ที่อ้างถึงด้านล่างจึงเป็นของ Cloudflare และผมจะบอกไว้ทุกจุด
Clef กับ Clairic คืออะไร ต่างจาก LLM ยังไง?
Cloudflare เรียกโมเดลกลุ่มนี้ว่า
System Oneตามแนวคิดของหนังสือ Thinking, Fast and Slow คือคิดเร็ว รอบเดียว ส่วน LLM อย่าง GPT หรือ Claude เป็น
System Twoที่ค่อยๆ คิดและเขียนทีละ token
- Clef (ตัดสินใจ):
ส่ง "state" (ข้อความ JSON หรือรูป) กับคำถามที่มีชนิดชัดเจนเข้าไป คำถามมีสามแบบ คือ noul (ใช่/ไม่ใช่), choice (เลือกหนึ่งจากตัวเลือกที่เรากำหนด) และ score (ให้คะแนนตามเกณฑ์ที่เรียงลำดับ) โมเดลตอบเป็นความน่าจะเป็นของทุกตัวเลือก ไม่มีทางตอบนอกตัวเลือก Clef ใช้ API แบบเดียวกับ Jev ของ Typesafe
- Clairic (ดึงค่า):
ส่ง state กับรายการ field ที่มีชนิดเข้าไป เช่น text, number, date, duration, list, estimate หรือ forecast โมเดลตอบเป็นค่าตามชนิดนั้น ถ้าในข้อมูลไม่มีค่านั้นก็ตอบ null พร้อม confidence และ p_null (โอกาสที่ค่านั้นไม่มีอยู่ใน input)
ทั้งคู่อ่าน input ในรอบเดียว (single forward pass) ไม่มีขั้นตอน "เขียน" คำตอบ Cloudflare จึงไม่คิดค่า output token ทุก response ที่ผมได้มามี output_tokens เป็น 0 จริง
ในตระกูลมีสี่โมเดล (ราคาและ context จากหน้า model ของ Workers AI ณ 4 พ.ย. 2026):
Model ID | ทำอะไร | ขนาด | Context (แบบ hosted) | ราคา (ต่อ 1M input token) | Input ที่รับ |
|---|---|---|---|---|---|
@cf/cloudflare/clef | ตัดสินใจ แม่นสุดในตระกูล | 27B | 65,536 | $0.24 | ข้อความ JSON รูป วิดีโอแบบชุดเฟรม |
@cf/cloudflare/clef-flash | ตัดสินใจ เน้นเร็วและถูก | 9B | 24,576 | $0.038 | ข้อความ JSON รูป วิดีโอแบบชุดเฟรม |
@cf/cloudflare/clef-omni | ตัดสินใจ รับเสียงและวิดีโอ | 30B MoE (active 3B) | 64,000 | $0.15 | ข้อความ รูป เสียง วิดีโอ |
@cf/cloudflare/clairic | ดึงค่า คำนวณ ประมาณ พยากรณ์ | ไม่ระบุ | 65,536 | $0.10 | ข้อความ รูป (preview) |
ทุกตัวไม่คิดค่า output token และหน้า model ระบุว่าเป็น zero data retention (ผมไม่ได้ลอง Clef-omni)
ควรใช้ตัวไหน: Clef, Clairic หรือ LLM ปกติ?
ถามตัวเองว่า "คำตอบที่ต้องการหน้าตาเป็นแบบไหน"
ถ้าคำตอบคือ... | ใช้ | ตัวอย่าง |
|---|---|---|
หนึ่งในตัวเลือกที่รู้ล่วงหน้า หรือ ใช่/ไม่ใช่ | Clef | ticket นี้ด่วนไหม ส่งทีมไหน เป็น spam ไหม ควรคืนเงินหรือซ่อม |
ค่าที่อยู่ใน input หรือคำนวณจาก input ได้ | Clairic | เลข order ยอดรวมรวมภาษี วันครบกำหนด จำนวนวันที่ส่งช้า |
ค่าประมาณที่ไม่มีใน input แต่มีหลักฐาน | Clairic (estimate) | ค่าซ่อมโดยประมาณ ราคาบ้านจากรายการขายใกล้เคียง |
ข้อความอิสระ เหตุผล หรือคำอธิบาย | LLM | ตอบอีเมลลูกค้า สรุปเอกสาร อธิบายว่าทำไม |
งานที่ต้องคิดหลายขั้น | LLM | คำนวณต่อกันหลายทอด วางแผน แก้โค้ด |
Cloudflare สรุปไว้สั้นๆ ว่า extraction model เปลี่ยน input ดิบให้เป็นค่า decision model เปลี่ยนค่าให้เป็นการตัดสินใจ และ LLM เปลี่ยนการตัดสินใจให้เป็นคำพูด
เรียก Clef จาก Worker ยังไง?
ก่อนอื่นต้องมี Workers AI binding ใน Wrangler config:
// wrangler.jsonc
{
  "ai": { "binding": "AI" }
}
ตัวอย่างนี้ตัดมาจากหน้า model ของ Clef: ส่งข้อความแจ้งปัญหาเข้าไป แล้วถามสามคำถามในครั้งเดียว
const response = await env.AI.run("@cf/cloudflare/clef", {
  state: "Checkout has been failing for every customer for the last hour.",
  questions: {
    urgent: { type: "noul", instructions: "Is this support request urgent?" },
    team: {
      type: "choice",
      instructions: "Which team should handle this request?",
      criteria: {
        billing: "Payments, invoices, and refunds",
        technical: "Outages, errors, and configuration",
        sales: "Plans and upgrades",
      },
    },
    severity: {
      type: "score",
      instructions: "How severe is the customer impact?",
      criteria: ["No impact", "Minor", "Major", "Critical"],
    },
  },
});
เอกสารบอกว่าต้องใส่ model: "clef" ใน body แต่ตอนลองจริง ส่งแบบไม่ใส่ก็ได้คำตอบเหมือนกันทุกตัวเลข ผมจึงตัดออก
เคล็ดลับ: เรียก Clef-flash ด้วย model ID ของมันเองคือ @cf/cloudflare/clef-flash ถ้าส่ง model: "clef-flash" ไปที่ @cf/cloudflare/clef จะได้ error 3030: Unsupported model 'clef-flash'. Use 'clef'. ผมเจอมาแล้วเก้าครั้ง
นี่คือ response จริงที่ได้ (ตัดให้สั้นลง):
{
  "model": "clef",
  "answers": {
    "urgent": { "type": "noul", "noul": 0.9895 },
    "team": {
      "type": "choice",
      "choice": "technical",
      "probabilities": { "billing": 0.1584, "technical": 0.8274, "sales": 0.0142 },
      "confidence": 0.5648
    },
    "severity": {
      "type": "score",
      "score": 2.9484,
      "legend": { "0": "No impact", "1": "Minor", "2": "Major", "3": "Critical" },
      "probabilities": { "0": 0.0043, "1": 0.0047, "2": 0.0292, "3": 0.9618 },
      "confidence": 0.9012
    }
  },
  "usage": { "input_tokens": 346, "output_tokens": 0 }
}
อ่านแต่ละแบบ:
- noul
ได้ค่าเดียว คือความน่าจะเป็นที่คำตอบเป็น "ใช่" (0.9895 คือด่วนแน่ๆ)
- choice
ได้ตัวเลือกที่น่าจะเป็นที่สุด ความน่าจะเป็นของทุกตัวเลือก (รวมกันได้ 1) และ confidence
- score
ได้คะแนนถ่วงน้ำหนักตามความน่าจะเป็น ซึ่งอาจตกอยู่ระหว่างสองระดับ (2.95 คือเกือบ Critical) พร้อม legend
ทุกคำตอบมี
typeและมี
usageที่ output_tokens เป็น 0
จุดที่ต้องระวัง:
confidence ไม่ใช่ความน่าจะเป็นของตัวที่เลือกข้อ team เลือก technical ที่ 0.8274 แต่ confidence แค่ 0.5648 ถ้าจะตั้งเกณฑ์ส่งให้คนตรวจ ให้ทดลองว่าจะใช้ค่าไหน
ข้อจำกัดของ request: ถามได้ 1–64 คำถาม แนบรูปได้ไม่เกิน 4 รูปแบบ base64 (ไม่รับ URL) และถ้า state ยาวเกิน context ส่วนที่เป็นข้อความจะถูกตัดให้พอดี
เรียก Clairic จาก Worker ยังไง?
ตัวอย่างนี้มาจากหน้า model ของ Clairic: อ่านใบแจ้งหนี้หนึ่งบรรทัด แล้วขอหกค่าในครั้งเดียว
const response = await env.AI.run("@cf/cloudflare/clairic", {
  state:
    "Invoice INV-2291 from Northwind Supply, issued 2026-09-02, net 30. 4 pallets at $250.00 each, shipping $80.00. Contact: Dana Ruiz, Priya Shah.",
  fields: {
    invoice_number: { type: "text" },
    due_date: { type: "date", instructions: "Issue date plus the net payment days" },
    total: { type: "number", decimals: 2, unit: "USD", instructions: "Amount due including shipping" },
    contacts: { type: "list", items: "text" },
    po_number: { type: "text", instructions: "Purchase order number" },
    days_to_pay: {
      type: "estimate",
      min: 0,
      max: 120,
      step: 1,
      instructions: "Days after issue until this invoice is paid",
    },
  },
});
response จริงที่ได้ (ปัดทศนิยมให้สั้นลง):
{
  "model": "clairic",
  "answers": {
    "invoice_number": { "type": "text", "p_null": 5.5e-6, "span": [8, 16], "guess": "INV-2291", "confidence": 0.99998, "value": "INV-2291" },
    "due_date": { "type": "date", "p_null": 9.6e-7, "guess": "2026-10-02", "confidence": 0.99996, "value": "2026-10-02" },
    "total": { "type": "number", "p_null": 5.5e-7, "guess": 1080, "confidence": 0.99995, "value": 1080 },
    "contacts": { "type": "list", "value": ["Dana Ruiz", "Priya Shah"], "spans": [[120, 129], [131, 141]], "confidence": 0.9998 },
    "po_number": { "type": "text", "p_null": 0.999999, "span": [8, 16], "guess": "INV-2291", "confidence": 0.9992, "value": null },
    "days_to_pay": { "type": "estimate", "value": 31, "mean": 30.94, "median": 31, "p10": 24, "p90": 37, "p_below": 2.3e-6, "p_above": 5.8e-6 }
  },
  "truncated": false,
  "usage": { "state_tokens": 61, "image_tokens": 0, "schema_tokens": 472, "input_tokens": 655, "output_tokens": 0, "passes": 3 }
}
ผลตรงกับเอกสารเกือบทั้งหมด:
- total = 1080
ไม่ได้เขียนไว้ใน input ตรงๆ โมเดลคำนวณ 4 × 250 + 80 ให้
- due_date
ได้จากวันออกใบบวก 30 วัน
- po_number เป็น null
เพราะใบนี้ไม่มีเลข PO แต่ guess ยังบอกว่าถ้าต้องเดาจะเดาอะไร ห้ามเอา guess ไปใช้แทน value
- span
บอกตำแหน่งตัวอักษรใน input ทำให้ไฮไลต์จุดที่มาในเอกสารต้นฉบับได้
- usage
ตรงกับเอกสารทุกตัว: 655 input token, output 0, 3 pass ที่ราคา $0.10 ต่อล้าน token ครั้งนี้ราว $0.00007
- ต่างจากเอกสารจุดเดียว:
days_to_pay ได้ 31 (ช่วง 80% คือ 24–37) แต่เอกสารแสดง 30 (21–38) ค่าแบบ estimate ไม่ได้ออกมาเท่ากันทุกครั้งเสมอไป
field อื่นที่ควรรู้: reference_date ใช้บอกปีให้วันที่ที่เขียนไว้โดยไม่มีปี และ options.include_quantiles ขอ percentile ครบ 99 ค่าของ estimate ได้ จำนวน field ไม่จำกัด ถ้าใส่ไม่พอในหนึ่ง pass (8,192 token) server จะแบ่งเป็นหลาย pass แบบขนานให้เอง
ต่อ Clairic → Clef → LLM ยังไงให้คุ้ม?
จุดที่ทำให้สองโมเดลนี้น่าสนใจคือใช้ต่อกันเป็น pipeline Cloudflare สาธิตด้วยเคสลูกค้าส่งอีเมลแจ้งสินค้าเสีย ผมรันตามนั้น แต่เปลี่ยน LLM ขั้นสุดท้ายเป็น @cf/ibm-granite/granite-4.0-h-micro เพราะ GLM-5.3 ที่ Cloudflare ใช้ต้องมี Workers Paid หรือเครดิต AI Gateway
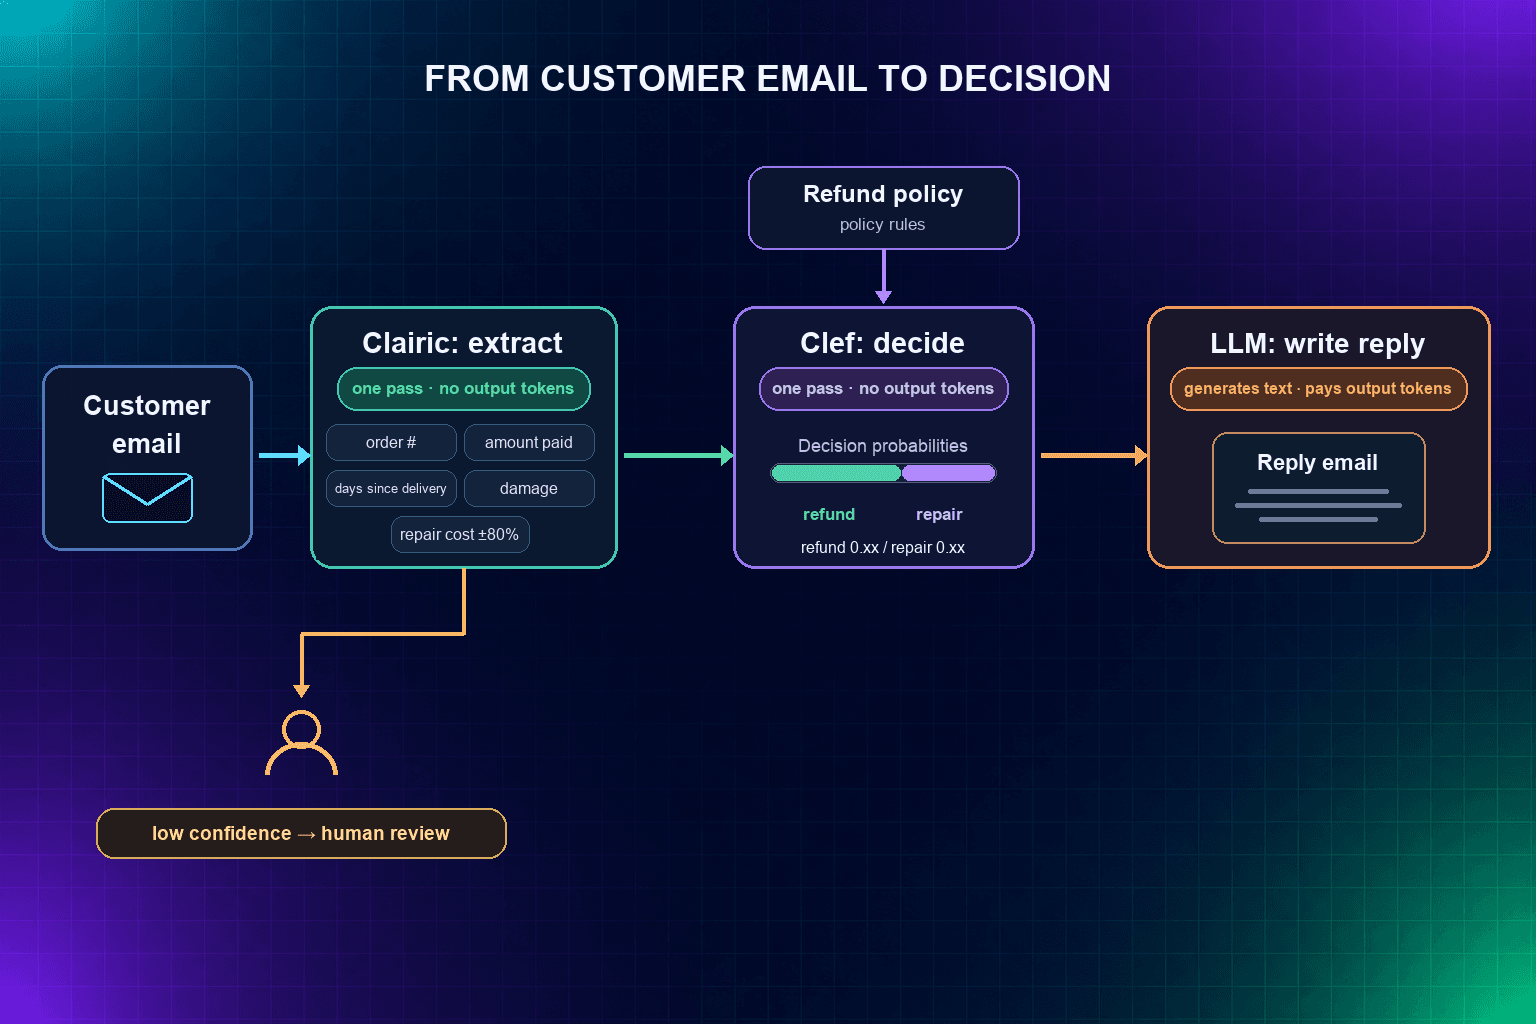
โค้ดย่อจาก index.ts ของ Worker ตัวอย่าง:
// 1) Clairic: อีเมล → ค่าที่มีชนิด
const facts = (
  await env.AI.run("@cf/cloudflare/clairic", {
    state: email,
    fields: {
      customer_name: { type: "text", instructions: "Customer's first name" },
      order_id: { type: "text", instructions: "Order number" },
      amount_paid: { type: "number", decimals: 2, unit: "USD", instructions: "Total paid including tax" },
      days_since_delivery: {
        type: "duration", unit: "days", integer: true,
        instructions: "Days from delivery to the date the customer wrote",
      },
      damage: { type: "list", items: "text", instructions: "Each kind of damage described" },
      repair_cost: {
        type: "estimate", unit: "USD", min: 10, max: 5000, scale: "log", step: 1,
        instructions: "Cost to repair the damage described",
      },
    },
  })
).answers;


// ยังไม่ได้ทดสอบ: ไม่เคยถูกเรียกในรอบที่รัน (0.9 เป็นแค่ตัวอย่าง)
const shaky = [facts.order_id, facts.amount_paid].some((f) => f.value === null || f.confidence < 0.9);
if (shaky) return sendToReview(email); // คิวตรวจของระบบเราเอง


// 2) Clef: ค่าที่ได้ + นโยบาย → การตัดสินใจหนึ่งข้อ
const options = {
  refund: "Full refund of the amount paid",
  repair: "Free repair, with a prepaid shipping label",
};
const { choice } = (
  await env.AI.run("@cf/cloudflare/clef-flash", { // หรือ @cf/cloudflare/clef
    state: `Damage claim for order ${facts.order_id.value}.
Paid: $${facts.amount_paid.value.toFixed(2)}. Delivered ${facts.days_since_delivery.value} days ago.
Damage reported: ${facts.damage.value.join(", ")}.
Estimated repair cost: $${facts.repair_cost.median} (80% range $${facts.repair_cost.p10}-$${facts.repair_cost.p90}).
Policy: refunds within 30 days of delivery. Prefer repair when it costs less than 60% of the price and the damage doesn't stop the product from working.`,
    questions: {
      resolution: { type: "choice", instructions: "What should we offer?", criteria: options },
    },
  })
).answers.resolution;


// 3) LLM: เขียนแค่คำตอบ จากการตัดสินใจและค่าที่จำเป็น
const llm = await env.AI.run("@cf/ibm-granite/granite-4.0-h-micro", {
  max_tokens: 150,
  messages: [{
    role: "user",
    content:
      `Write a short, warm reply to ${facts.customer_name.value}. Use only these facts: ` +
      `order ${facts.order_id.value}; damage: ${facts.damage.value.join(", ")}; ` +
      `what happens next: ${options[choice]}. Under 60 words.`,
  }],
});
const reply = llm.choices[0].message.content; // Granite ตอบแบบ OpenAI ไม่ใช่ { response }
ผลจริงจากอีเมลสมมติหนึ่งฉบับ (เครื่องปั่นโถแก้วร้าว ฝาปิดไม่ล็อก จ่าย $129 ส่งถึงมา 19 วัน) รันสองรอบ รอบแรกให้ Clef-flash ตัดสินใจ รอบสองใช้ Clef (27B) เวลาวัดใน Worker รอบละครั้งเดียว:
ขั้น | Clef-flash ตัดสินใจ | Clef ตัดสินใจ |
|---|---|---|
1. Clairic ดึงค่า | 361 ms, 795 input token | 241 ms, 795 input token |
2. ตัดสินใจ | 144 ms, 239 token → refund(0.597, confidence 0.038) | 264 ms, 239 token → repair(0.768, confidence 0.287) |
3. Granite เขียนคำตอบ | 2,506 ms, 77 in / 56 out | 2,189 ms, 79 in / 59 out |
ทั้ง pipeline (round trip) | 3,197 ms | 2,750 ms |
สิ่งที่เห็นจากการรันจริง:
- สองขั้นแรกใช้ไม่ถึงครึ่งวินาที
อยู่ในช่วงเดียวกับที่ Cloudflare รายงาน (0.46 และ 0.22 วิ) เวลาส่วนใหญ่ไปอยู่ที่ LLM ส่วนขั้นที่ 3 เทียบกับ demo ไม่ได้ เพราะ Granite micro เป็นโมเดลเล็กมาก ส่วน GLM-5.3 ตัวใหญ่
- Clef สองขนาดตัดสินใจไม่ตรงกัน
นโยบายบอกให้ซ่อมเมื่อค่าซ่อมต่ำกว่า 60% ของราคา ค่าซ่อมประมาณ (median $114–115) คือราว 89% ของ $129 และฝาที่ไม่ล็อกทำให้ใช้งานไม่ได้ ตามนโยบายควรเป็น refund Clef-flash เลือกถูก ส่วน Clef ตัวใหญ่เลือก repair
แต่ทั้งคู่มี confidence ต่ำมากเคสเดียวพิสูจน์อะไรไม่ได้ แต่เห็นชัดว่าทำไมต้องดู confidence ก่อนปล่อยอัตโนมัติ
- รายการความเสียหายได้ confidence แค่ 0.22
ทั้งที่เนื้อหาใกล้เคียง ("glass jar", "lid doesn't latch" แต่ตกคำว่า cracked) เงื่อนไข shaky ข้างบนดูแค่ order_id กับ amount_paid จึงไม่จับเคสนี้ ถ้าจะใช้ confidence ส่งงานให้คน ควรรวม field แบบ list ด้วย และเผื่อว่ามันจะต่ำเป็นปกติ
- order_id ได้ "#A-48213" ติดเครื่องหมาย #
มาด้วย เพราะ Clairic คัดลอก span ตามที่เขียน
- ค่าประมาณไม่นิ่ง 100%
ค่าซ่อมได้ median 115 ในรอบแรก และ 114 ในรอบสอง จากอีเมลเดียวกัน (ต่างกันนิดเดียว แต่ไม่ใช่ "เท่ากันทุกครั้ง")
ทำไมแบบนี้ถึงถูกกว่า:
- 1.สองขั้นแรกไม่มี output token
ในตารางราคา LLM อย่าง GLM-5.3 คิด output token แพงกว่า input ราวสามเท่า ($4.40 เทียบ $1.40 ต่อล้าน token) ถ้าให้ LLM ทำทั้งสามขั้น เราจ่ายค่า "พิมพ์ JSON" สองรอบก่อนจะถึงคำตอบจริง
- 2.LLM เห็นข้อมูลน้อยลง
ขั้นสุดท้ายในรอบที่ผมรันได้ input แค่ 77–79 token แทนอีเมลเต็มฉบับ
- 3.Clef ตัดสินใจจากสรุปห้าบรรทัด ไม่ใช่อีเมลดิบ
Cloudflare บอกว่าช่วยลดโอกาสโดน prompt injection จากข้อความลูกค้า (ลดได้ ไม่ใช่กันได้ 100%)
- 4.ทุกขั้นตรวจสอบย้อนหลังได้
ค่าที่ดึงมามี confidence และ span การตัดสินใจมีความน่าจะเป็น
ส่วนตัวเลขของ Cloudflare เอง (pipeline เดียว งานเดียว ใช้ GLM-5.3 เขียนคำตอบทั้งสองแบบ):
Clairic → Clef → GLM-5.3 | GLM-5.3 ทุกขั้น | |
|---|---|---|
1. ดึงค่า | 0.46 วิ | 16.1 วิ |
2. ตัดสินใจ | 0.22 วิ | 21.9 วิ |
3. เขียนคำตอบ | 18.6 วิ | 16.4 วิ |
รวมทั้งหมด (ตามที่ Cloudflare รายงาน) | 19.3 วิ | 61.7 วิ |
ค่าใช้จ่ายต่อหนึ่งล้านเคส | $6,032 | $11,740 |
อ่านตารางนี้ให้ครบ: เวลาแต่ละขั้นของฝั่ง all-LLM รวมกันได้
54.4 วินาที ไม่ใช่ 61.7และบล็อกไม่ได้อธิบายส่วนต่าง ถ้าใช้ 54.4 วินาที cascade เร็วกว่าราว 2.8 เท่า ไม่ใช่ 3.2 เท่า ส่วนที่ประหยัด 49% ตรงกับตาราง แต่ค่าใช้จ่ายส่วนใหญ่ของ cascade ยังเป็น output token ของ LLM ขั้นสุดท้าย ($5,848 จาก $6,032) ถ้างานต้องเขียนคำตอบยาว ส่วนต่างจะแคบลง ถ้าไม่ต้องเขียนอะไรเลย (เช่น แค่ route ticket) ส่วนต่างจะกว้างขึ้นมาก ผมไม่ได้รัน GLM-5.3 จึงยืนยันตัวเลขชุดนี้ไม่ได้
Clef กับ Clairic ใช้กับภาษาไทยได้ดีแค่ไหน?
Cloudflare ไม่ได้บอกว่ารองรับภาษาไหน และไม่มีผลทดสอบภาษาไทยเลย ผมจึงลองเอง ข้อมูลทั้งหมดเป็นข้อมูลสมมติ และจำนวนน้อยมาก ให้อ่านเป็นสัญญาณ ไม่ใช่ข้อสรุป
ห้าข้อความ คำถามและคำอธิบายตัวเลือกเป็นภาษาไทยทั้งหมด ถามสองข้อ: ด่วนไหม (noul) และส่งทีมไหน (billing, technical, sales, other)
ข้อความ | Clef-flash ตอบ | คนเลือก | ผล |
|---|---|---|---|
เว็บสั่งซื้อใช้ไม่ได้มาตั้งแต่เช้า ลูกค้าจ่ายเงินไม่ได้เลยค่ะ ด่วนมาก | ด่วน 0.94; billing 0.65, confidence 0.30 | ด่วน; technical | ⚠️ หมวดไม่ตรง |
ขอใบกำกับภาษีย้อนหลังของเดือนกันยายนหน่อยครับ ไม่รีบ | ด่วน 0.06; billing 0.91, confidence 0.78 | ไม่ด่วน; billing | ✅ |
โดนตัดเงินซ้ำสองรอบเลยค่ะ ช่วยคืนเงินให้ด้วย | ด่วน 0.04; billing 0.51, confidence 0.26 | billing (ด่วนไหมแล้วแต่มุมมอง) | ✅ แต่ไม่มั่นใจ |
สนใจอัปเกรดเป็นแพ็กเกจรายปีครับ มีส่วนลดไหม | ด่วน 0.06; sales 0.96, confidence 0.89 | ไม่ด่วน; sales | ✅ |
ขอบคุณมากครับ ตอนนี้ใช้งานได้แล้ว | ด่วน 0.14; other 0.93, confidence 0.83 | ไม่ด่วน; other | ✅ |
- หมวดถูก 4 จาก 5
และธง "ด่วน" ถูกทุกข้อที่ชัดเจน
ข้อที่พลาดส่วนหนึ่งมาจากผมเอง คำอธิบาย billing มีคำว่า "การชำระเงิน" ซึ่งทับกับ "ลูกค้าจ่ายเงินไม่ได้"
- สองคำตอบที่อ่อนที่สุดคือสองข้อที่ confidence ต่ำที่สุด
(0.30 และ 0.26) ถ้าตั้งเกณฑ์ไว้ราว 0.5 ทั้งสองข้อจะถูกส่งให้คนตรวจ ซึ่งเป็นพฤติกรรมที่เราต้องการ
แต่ละครั้งใช้เวลาใน Worker 104–342 ms
ข้อควรรู้: คอลัมน์ "คนเลือก" ผมเขียนหลังเห็นผลแล้ว และทั้งห้าข้อความสั้นและค่อนข้างชัด
ใบเสร็จสมมติ ลงวันที่ 15 ต.ค. 2569 (คือ 15 ตุลาคม 2026) ยอดรวม 215 บาท ส่งไปทั้งแบบข้อความ และแบบรูป PNG ที่วาดขึ้นเองด้วยโปรแกรม
Field | ค่าจริง | จากข้อความ | จากรูป |
|---|---|---|---|
เลขที่ใบเสร็จ | RC-2569-0042 | ✅ RC-2569-0042 (0.999) | ⚠️ RC-2569-004 ตกหนึ่งหลัก (0.946) |
วันที่ | 2026-10-15 | ❌ 2069-10-15 (0.983) | ❌ 2066-12-15 (0.162) |
ยอดรวม | 215 | ✅ 215 (0.9997) | ✅ 215 (0.987) |
รายการสินค้า | กาแฟเย็น, ครัวซองต์ | ⚠️ ได้ครบแต่ติดบรรทัด VAT มาด้วย (0.17) | ❌ ได้แค่ "อ" (0.54) |
- ยอดเงินและเลขที่ใบเสร็จเชื่อได้เมื่อส่งเป็นข้อความ
- ปี พ.ศ. ผิดแบบมั่นใจ
แม้ใส่คำสั่งให้แปลง พ.ศ. เป็น ค.ศ. ก็ได้ 2069 (confidence 0.983) และเมื่อตัดคำสั่งออกยังได้ 2069 ที่ confidence 0.9998 ซึ่งไม่ใช่ทั้งปี พ.ศ. และ ค.ศ. ที่ถูก เกณฑ์ confidence จึงจับไม่ได้
- วิธีที่ใช้ได้:
ขอวันที่เป็น field แบบ text แทน Clairic คืน "15 ต.ค. 2569" ตรงตามต้นฉบับ (confidence 0.995 พร้อม span) แล้วให้โค้ดแปลง พ.ศ. → ค.ศ. เอง
- อ่านจากรูปยังอ่อน
รูปของผมเป็นรูปวาดที่สะอาดและเรียบง่าย แต่ยังตกตัวเลขและอ่านชื่อสินค้าไม่ออก ผมลองแค่รูปเดียว จึงบอกอะไรเกี่ยวกับรูปถ่ายจริงไม่ได้
รายการแบบ list เป็นจุดอ่อน confidence ต่ำทั้งสองแบบ
ขอวันที่เป็นข้อความ แล้วแปลงเองในโค้ด:
// field ที่ส่งให้ Clairic
// date_as_written: { type: "text", instructions: "วันที่ตามที่เขียนในใบเสร็จ" }


const TH_MONTHS = ["ม.ค.", "ก.พ.", "มี.ค.", "เม.ย.", "พ.ค.", "มิ.ย.", "ก.ค.", "ส.ค.", "ก.ย.", "ต.ค.", "พ.ย.", "ธ.ค."];


// "15 ต.ค. 2569" -> "2026-10-15"; รองรับแค่ชื่อเดือนแบบย่อ คืน null ถ้ารูปแบบไม่ตรง
function thaiDateToIso(text: string): string | null {
  const m = text.trim().match(/^(\d{1,2})\s+(\S+)\s+(\d{4})$/);
  if (!m) return null;
  const month = TH_MONTHS.indexOf(m[2]) + 1;
  if (!month) return null;
  return `${Number(m[3]) - 543}-${String(month).padStart(2, "0")}-${m[1].padStart(2, "0")}`;
}
สรุปภาษาไทย:
ใช้ Clef ตัดสินใจจากข้อความไทยได้ดีพอจะลองต่อโดยดู confidence ประกอบ
ใช้ Clairic ดึงตัวเลขจากข้อความไทยได้แต่วันที่ให้ดึงเป็นข้อความแล้วแปลงเอง และยังไม่ควรพึ่งการอ่านรูปภาษาไทย
ลองจริงเสียเงินเท่าไหร่?
ทั้งหมดที่รันด้านบนใช้ไปราว
86 Neuronsจากโควตาฟรี 10,000 Neurons ต่อวัน จึง
ไม่เสียเงินเลย(ประมาณจาก usage.input_tokens ของแต่ละ response กับอัตรา Neurons ในหน้าราคา)
โมเดล | เรียกสำเร็จ | Input token | Output token | Neurons โดยประมาณ |
|---|---|---|---|---|
Clairic | 8 | 6,136 | 0 | 55.8 |
Clef (27B) | 3 | 931 | 0 | 20.3 |
Clef-flash | 7 | 2,360 | 0 | 8.2 |
Granite 4.0 micro (LLM) | 2 | 156 | 115 | 1.4 |
รวม | 20 | ราว 86 |
ถ้าคิดทุก Neuron ในอัตราแบบจ่ายเงิน ($0.011 ต่อ 1,000 Neurons) จะได้ราว $0.0009
รูปไม่ได้คิดแพงกว่า รูป PNG ขนาด 640×520 นับเป็น 320 image token และคิดในอัตรา input ปกติ
โควตาฟรีน่าจะครอบคลุมโมเดลเหล่านี้ เพราะไม่มี call ไหนตอบ error ว่าต้องใช้ plan แบบจ่ายเงิน แต่ผมไม่ได้ยืนยันจากหน้า billing
มีอีกเก้าครั้งที่ล้มเพราะ error 3030 (เรียก clef-flash ผิด ID) ผมคิดว่าไม่ถูกคิดเงิน แต่ไม่ได้ตรวจ ถ้าถูกคิดก็เพิ่มแค่ราว 12 Neurons
ก่อนเปิด Worker ที่เรียก AI ต้องกันอะไรบ้าง?
อย่าเปิด endpoint ที่เรียก AI ทิ้งไว้โดยไม่มีตัวกัน ใครเจอ URL ก็ใช้ Neurons ของเราได้ Worker ตัวอย่างของผมเช็ก bearer secret ก่อนเรียกโมเดลทุกครั้ง (ถ้า deploy สำเนาจาก gist ไปลอง ให้ตั้ง secret ก่อนแชร์ URL ให้ใคร และลบ Worker เมื่อเลิกใช้):
async function authorized(request: Request, secret?: string): Promise<boolean> {
  if (!secret) return false;
  const enc = new TextEncoder();
  const [a, b] = await Promise.all(
    [request.headers.get("Authorization") ?? "", `Bearer ${secret}`].map((s) =>
      crypto.subtle.digest("SHA-256", enc.encode(s)),
    ),
  );
  return (crypto.subtle as any).timingSafeEqual(a, b); // API ของ Workers เทียบแบบไม่รั่วเวลา
}


// ใน fetch(): ไม่ผ่านก็ตอบ 401 ก่อนเรียก env.AI.run
if (!(await authorized(request, env.AUTH_SECRET))) return new Response("unauthorized", { status: 401 });
ตั้ง secret ด้วย Wrangler (ค่าจะไม่ไปอยู่ในโค้ดหรือ config):
npx wrangler secret put AUTH_SECRETนอกจากนี้ Worker ตัวอย่างจำกัดขนาด body ไว้ที่ 256 KB และจำกัดจำนวน question หรือ field ต่อ request ด้วย ตอนทดสอบ request ที่ไม่มี secret ได้ 401 body ใหญ่เกินได้ 413 และถามเกินจำนวนได้ 400 โดยไม่มีการเรียกโมเดลเลย
ตัวเลข benchmark ของ Cloudflare เชื่อได้แค่ไหน?
ตัวเลขในส่วนนี้
Cloudflare วัดเองทั้งหมดผมไม่ได้เทียบกับ Jev และไม่ได้วัดความเร็วแบบ benchmark จึงยืนยันไม่ได้ และในแหล่งที่ผมอ่านไม่มีการทดสอบซ้ำโดยบุคคลที่สาม
- ความเร็ว:
changelog บอกว่าจาก 43 benchmark run ค่ากลาง latency ของ Clef คือ 209.3 ms, Clef-flash 38.8 ms และ Jev 524.1 ms ซึ่งเป็นที่มาของคำว่า "Clef-flash เร็วกว่า Jev 13 เท่า" (524.1 ÷ 38.8) ต่อมาวันที่ 9 ต.ค. Cloudflare ปรับ serving ของ Clef ให้เร็วขึ้นอีก เวลาที่ผมวัดใน Worker รวม overhead ของ binding ด้วย จึงเอามาเทียบกับตัวเลขชุดนี้ไม่ได้
- ความแม่น:
changelog บอกว่า "นำ 7 จาก 10 benchmark" แต่ 10 ข้อนั้นเป็นชุดที่คัดมา บน model card ของ Hugging Face มีผลครบ 41 benchmark ผมนับแล้ว Clef หรือ Clef-flash ได้คะแนนสูงสุด 27 ข้อ และ Jev ได้ 11 ข้อ ข้อที่ Jev ชนะชัดเป็นงานที่ต้องใช้เหตุผล เช่น GPQA Diamond (78.3 เทียบ 48.0) และ BBH (92.9 เทียบ 73.7)
- workflow eval ของ Typesafe:
Clef ชนะ Jev 3 ใน 4 ด้าน แพ้ด้าน agent trace observability และช่องว่างส่วนใหญ่แคบ ไม่กี่จุด
สรุปคือ Clef เด่นเรื่องความเร็วและงานจัดหมวดหมู่ แต่ไม่ได้ดีกว่าทุกด้าน ถ้าการตัดสินใจต้องคิดหลายขั้น LLM อาจเหมาะกว่า
ข้อจำกัดที่ต้องรู้ก่อนใช้จริง
- Clairic ยังเป็น preview
Cloudflare บอกว่าเป็น checkpoint แรกๆ และจะเปิด weights "เร็วๆ นี้" แต่ไม่ได้ให้วันที่ หน้า model เขียนเงื่อนไขว่าให้บริการแบบ "AS IS" และอาจหยุดให้บริการได้
- คำนวณหลายขั้นยังไม่แม่น
Cloudflare เองบอกว่าการคำนวณหนึ่งถึงสองขั้นเชื่อได้ แต่ถ้าต้องคำนวณต่อกันหลายทอด ให้ Clairic ดึงค่าแล้วให้โค้ดคำนวณเอง (วันที่ พ.ศ. ก็เช่นกัน)
- confidence ไม่ได้จับทุกความผิด
สำหรับ Clef ในการทดสอบของผม confidence ต่ำตรงกับคำตอบที่อ่อน แต่ Clairic ให้วันที่ผิดด้วย confidence 0.98–0.9998
- ค่าประมาณต้องมีหลักฐาน
ช่วง 80% อาจแคบเกินจริงกับข้อมูลที่โมเดลไม่คุ้น และ forecast ไม่ได้ออกแบบมาแทนโมเดล time series
- context ของ Clef-flash ถูกลดลง
ตอนเปิดตัว (1 ต.ค.) บอก 64K แต่หลังลดราคา (9 ต.ค.) แบบ hosted เหลือ 24,576 token ถ้าต้องการ context ยาว Cloudflare แนะนำให้ใช้ Clef แทน (ผมไม่ได้ทดสอบขีดจำกัดนี้)
- รูปและสื่อนับเป็น token
รูปหนึ่งรูปใช้ได้ถึง 1,024 token ถ้าสื่อเกิน context ทั้ง request จะ fail และต้องส่งเป็น base64 เท่านั้น
- ผลออกมาถูก "ชนิด" เสมอ แต่ไม่ได้ถูก "ค่า" เสมอ
ใช้ confidence, p_null และช่วง 80% ตัดสินว่าอะไรปล่อยอัตโนมัติได้ และอะไรต้องให้คนตรวจ
FAQ
Clef กับ Clairic เป็น LLM ไหม?
ไม่ใช่ในความหมายปกติ ข้างในใช้ backbone ของ LLM (Clef ใช้ Qwen) แต่ Cloudflare ตัดส่วนสร้างข้อความออก ให้อ่าน input รอบเดียวแล้วให้คะแนนตัวเลือกหรือถอดค่าตามชนิดแทน จึงเขียนข้อความอิสระไม่ได้ และทุก response ที่ผมได้มี output_tokens เป็น 0
ใช้กับภาษาไทยได้ไหม?
ได้ แต่ต้องระวังบางจุด ในการทดสอบเล็กๆ ของผม Clef-flash จัดหมวดข้อความไทยถูก 4 จาก 5 และสองคำตอบที่อ่อนที่สุดมี confidence ต่ำสุด Clairic อ่านยอดเงินและเลขที่ใบเสร็จจากข้อความไทยได้ถูก แต่อ่าน "15 ต.ค. 2569" เป็น 2069-10-15 ด้วย confidence สูง ให้ขอวันที่เป็นข้อความแล้วแปลง พ.ศ. → ค.ศ. ในโค้ด และอย่าเพิ่งพึ่งการอ่านรูปภาษาไทย
ราคาเท่าไหร่ มีใช้ฟรีไหม?
ต่อหนึ่งล้าน input token: Clef $0.24, Clef-flash $0.038, Clef-omni $0.15 และ Clairic $0.10 ไม่มีค่า output token Workers AI มีโควตาฟรี 10,000 Neurons ต่อวัน การทดสอบทั้งหมดของผมราว 20 ครั้งใช้ไปประมาณ 86 Neurons จึงไม่เสียเงิน โควตาฟรีน่าจะครอบคลุมโมเดลเหล่านี้ (ไม่มี error ว่าต้องจ่ายเงิน) แต่ยังไม่ได้ยืนยันจากหน้า billing
ทำไมเรียก clef-flash แล้วได้ error 3030?
เพราะส่ง model: "clef-flash" ไปที่ model ID ของ Clef ต้องเรียก @cf/cloudflare/clef-flash โดยตรง ส่วน field model ใน body ของ Clef ไม่ต้องใส่ก็ได้
ใช้ Jev อยู่แล้ว ย้ายมา Clef ยากไหม?
Cloudflare บอกว่า Clef ใช้ API รูปแบบเดียวกับ Jev (System One API) เปลี่ยน endpoint กับชื่อ model ก็พอ ผมไม่ได้ลองย้ายจริงหรือเทียบผลกับ Jev ควรรัน eval ของเราเองซ้ำก่อนสลับ
รันเองบนเครื่องได้ไหม?
Clef, Clef-flash และ Clef-omni เปิด weights บน Hugging Face แบบ Apache 2.0 และ serve ด้วย SGLang ได้ (model card ทดสอบบน GPU H200 หนึ่งตัว) ส่วน Clairic ยังไม่เปิด weights ตอนนี้ใช้ได้แค่ผ่าน Workers AI
สรุป
Clef กับ Clairic ไม่ได้มาแทน LLM แต่มารับงานส่วนที่เราใช้ LLM อย่างสิ้นเปลือง คือการเลือก label และการอ่านค่าออกจากเอกสาร
✅ เลือกจากตัวเลือกที่รู้ล่วงหน้า → Clef (Clef-flash ถูกสุด และกับข้อความไทยห้าข้อความก็ทำได้ดี)
✅ ดึงตัวเลขและเลขที่เอกสารจากข้อความ → Clairic (ยังเป็น preview)
⚠️ วันที่ พ.ศ. → ขอเป็นข้อความแล้วแปลงเองในโค้ด
✅ ต้องเขียนข้อความหรือคิดหลายขั้น → LLM เหมือนเดิม
⚠️ benchmark และ demo เป็นของ Cloudflare การทดสอบของผมเล็กมาก ทดสอบกับข้อมูลของเราเองก่อนเสมอ
Last verified: 5 พฤศจิกายน 2026 จากการรัน Worker ตัวอย่างบน Workers free tier (ลบ Worker ไปแล้วหลังทดสอบ) บล็อก changelog และหน้า model ของ Cloudflare กับ model card บน Hugging Face
แหล่งอ้างอิง: